



친사회성 역대 최고… 앤트로픽, ‘클로드 오푸스 4.8’ 출시
불일치 행동 제어 개선… ‘미토스 프리뷰’ 수준
 구글 검색 선호 매체로 추가
앤트로픽은 28일(현지 시간) 최신 플래그십 대형언어모델(LLM)인 ‘클로드 오푸스 4.8(Claude Opus 4.8)’을 출시했다. 전작보다 성능 전반이 개선된 모델로, 할루시네이션은 줄고 에이전트 기능은 대폭 강화됐다.
앤트로픽에 따르면, 오푸스 4.8의 가장 큰 특징은 뛰어난 ‘정직성’과 오류 검증 능력이다. 스스로 판단하기에 근거가 부족하거나 불확실한 결과물에 대해 억지로 답변을 만들어내는 할루시네이션(환각) 현상을 크게 줄였다. 특히 코딩 작업 시 결함이 있는 코드를 인지하지 못하고 그대로 출력할 확률이 전작 대비 4배나 감소해, 자체적으로 오류를 검증하는 정밀함을 갖췄다.
또 자체 정렬 평가 결과, 오푸스 4.8은 사용자의 자율성을 존중하고 최선의 이익을 위해 행동하는 ‘친사회적 특성(Prosocial traits)’ 부문에서 역대 최고점을 기록한 것으로 알려졌다. 생성형 AI의 고질적 결함으로 꼽히는 ‘불일치 행동(Misaligned behavior)’ 제어 측면에서도 성과를 거뒀다. 거짓 정보를 제공하는 기만 행위나 악의적인 요청에 동조하는 오용 협력율이 전작보다 훨씬 낮아졌다. 앤트로픽 모델 중 최고 수준의 정렬 모델로 평가받는 ‘클로드 미토스 프리뷰(Claude Mythos Preview)’와 유사한 수준이라는 평이다.
‘에이전트’ 성능 지표에서도 눈에 띄는 도약을 이뤄냈다. 우선 개발자 에이전트의 실제 소프트웨어 해결 능력을 평가하는 ‘SWE-벤치 프로(SWE-bench Pro)’에서 오푸스 4.8은 69.2%의 점수를 기록했다. 전작인 오푸스 4.7(64.3%)는 물론, 경쟁 모델인 오픈AI의 GPT-5.5(58.6%)와 구글의 제미나이 3.1 프로(54.2%)를 크게 따돌린 수치다. 복잡한 코딩 엔지니어링 환경에서 업계 최고 수준의 자율 작업 성능을 입증한 셈이다.
운영체제(OS) 환경을 인간처럼 다루는 능력을 측정하는 ‘OS월드-검증(OSWorld-Verified)’ 지표에서도 83.4%를 기록하며 선두를 지켰다. 지식 노동 생산성을 평가하는 ‘GDPval-AA’에서는 1890점을 획득해 전작(1753점)과 GPT-5.5(1769점)를 따돌렸다. 고난도 금융 분석 및 예측 모델링 평가인 ‘Finance Agent v2’ 역시 53.9%로 가장 높은 점수를 보였다.
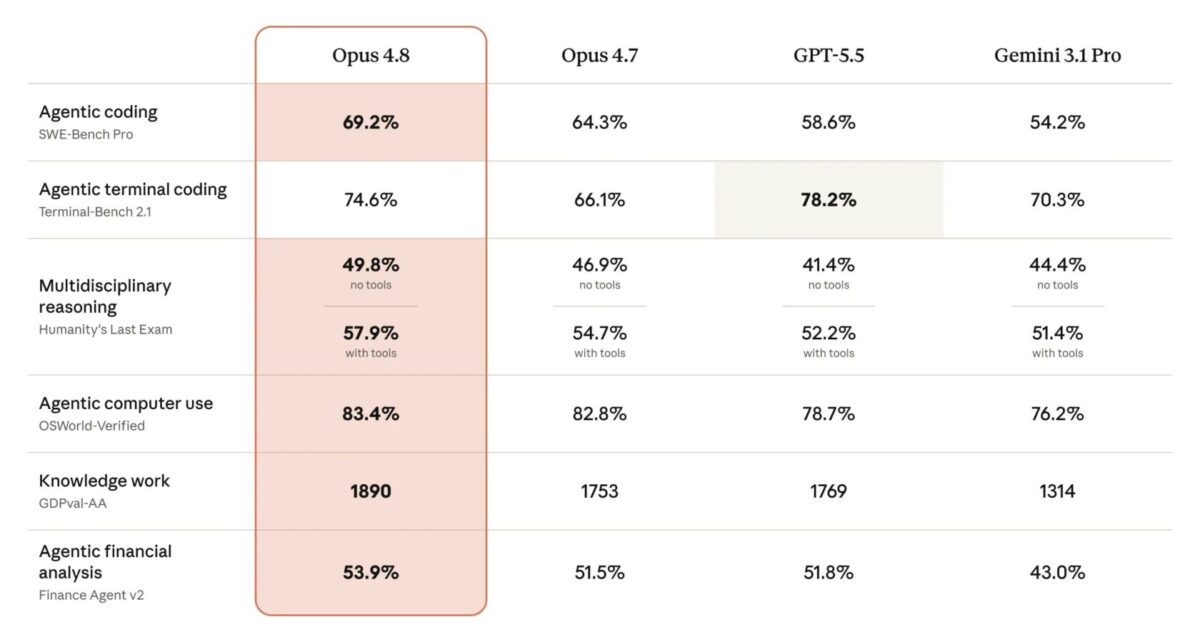
도구 사용 여부에 따른 다학제적 추론(Multidisciplinary reasoning) 평가인 ‘인류의 마지막 시험(Humanity’s Last Exam)’ 결과는 외부 도구 사용 유무에 따라 10% 가까이 차이가 발생했다. 오푸스 4.8은 외부 도구 없이 순수 추론을 진행했을 때 49.8%를 기록했으나, 도구 결합 시 57.9%로 점수가 치솟았다.
다만, 명령형 인터페이스 내 작업 능력을 평가하는 ‘터미널 벤치 2.1(Terminal-Bench 2.1)’에서는 오푸스 4.8이 74.6%로 전작(66.1%) 대비 크게 발전했으나, GPT-5.5(78.2)를 넘지는 못했다.
엔트로픽 관계자는 “오푸스 4.8은 전작 대비 확실히 개선됐지만 아직 갈 길이 멀다”며 “오푸스 수준의 고성능을 더 낮은 비용을 제공하는 모델을 개발하는 중이며, 오푸스보다 뛰어난 지능을 가진 새로운 등급의 모델도 선보일 계획”이라고 밝혔다.
한편, 클로드 오푸스 4.8은 출시 당일부터 전 세계 API와 플랫폼에 즉시 적용됐다. 일반 사용 요금은 입력 토큰 100만개당 5달러, 출력 토큰 100만개당 25달러로 전작과 동일하다. 고속 모드 요금은 입력 토큰 100만개당 10달러, 출력 토큰 100만개당 50달러 수준이다.
뉴스콘텐츠는 저작권법 제7조 규정된 단서조항을 제외한 저작물로서 저작권법의 보호대상입니다. 본 기사를 개인블로그 및 홈페이지, 카페 등에 게재(링크)를 원하시는 분은 반드시 기사의 출처(로고)를 붙여주시기 바랍니다. 영리를 목적으로 하지 않더라도 출처 없이 본 기사를 재편집해 올린 해당 미디어에 대해서는 합법적인 절차(지적재산권법)에 따라 그 책임을 묻게 되며, 이에 따른 불이익은 책임지지 않습니다.
- 에디터최석영 (csyeong720@ditoday.com)